支持向量机 (SVM) 这是一种分类方法。在此算法中,我们将每个元素绘制为 n 维空间中的一个点(其中 n 是其具有的特征数量),其中每个特征的值是特定坐标的值。 例如,如果我们只有两个特征,例如人的身高和头发长度,我们首先将这两个变...
朴素贝叶斯 它是一种基于贝叶斯定理的分类技术,假设预测变量之间独立。简而言之,朴素贝叶斯分类器假设类中某些特征的存在独立于其他特征的存在。例如,红色、圆形、直径约 3 英寸的水果可以被视为苹果。即使这些特征相互依赖或存在其他特征,朴素贝叶斯...
KNN(k近邻)可以用来解决分类和回归问题。但它在工业分类问题上应用更为广泛。 K 最近邻是一种简单的算法,它存储所有可用案例并通过 k 个邻居的多数投票对新案例进行分类。分配给一个类的状态通常是根据 K 个最近邻居之间的距离来衡量的。 这...
K-Means(K-means算法)是一种解决聚类问题的无监督算法。该过程遵循一种简单易行的方法,根据特定数量的簇(例如 k 个簇)对给定数据集进行分类。集群内的数据点对于对等组来说是同质的和异构的。 你还记得从墨迹中寻找形状吗? K 代表...
随机森林随机森林是决策树集合的商标。在随机森林中,我们收集决策树(称为“森林”)。为了根据属性对新对象进行分类,每棵树都会被赋予一个分类,我们将该树称为该类的“投票”。森林选择得票最多的类别(在森林中的所有树木中)。 每棵树的种植和生长过程...
在过去 4-5 年中,所有可能过程中的数据提取都急剧增加。公司/政府机构/研究机构不仅提供新的来源,还获得详细的数据。 示例:电子商务公司捕获有关其客户的更多详细信息,例如人口统计、网络爬行历史记录、喜欢和不喜欢、购买历史记录、评论和更多...
梯度提升算法10.1 GBMGBM(梯度提升机)是一种提升类型,用于处理大量数据以创建高度预测的预测算法。 Boosting 实际上是一组学习算法,它结合了多个基本估计器的预测,以提高与单个估计器相比的鲁棒性。它将多个弱或平均预测变量组...
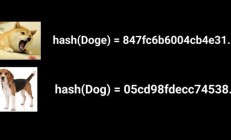
如果你学习区块链科技,你就会听说哈希和哈希算法,这似乎是无处不在的安全保障。例如,像比特币或以太坊这样管理去中心化网络和共识的机器将拥有通过 P2P 连接的数万个节点,并且需要“可信”和可验证的效率。这些系统要求信息以紧凑的格式写入,以便参...
数据结构是计算机科学中的基本概念,有助于用任何语言编写高效的程序。 Python是一种高级、解释性、交互式、面向对象的脚本语言,它使我们比其他编程语言更容易学习数据结构的基础知识。 在本章中,我们将概述一些常见的数据结构及其与某些特定Pyt...
数组是可以容纳多个相同类型的项目的容器。大多数数据结构使用数组来实现算法。以下是理解数组(Array)概念的重要术语。 Element - 存储在数组中的每个项目称为元素。 索引 - 数组中的每个元素位置都有一个标识该元素的数字索引。 数...
分享好东西,收藏啦!
 code前端网



 css动画无限循环 3年前 (2023-09-07)
 新手必须掌握的 10 个 CSS 技能 3年前 (2023-09-07)
 CSS 显示属性 3年前 (2023-09-07)CSS calc() 函数 3年前 (2023-09-07)
分享好东西,收藏啦!